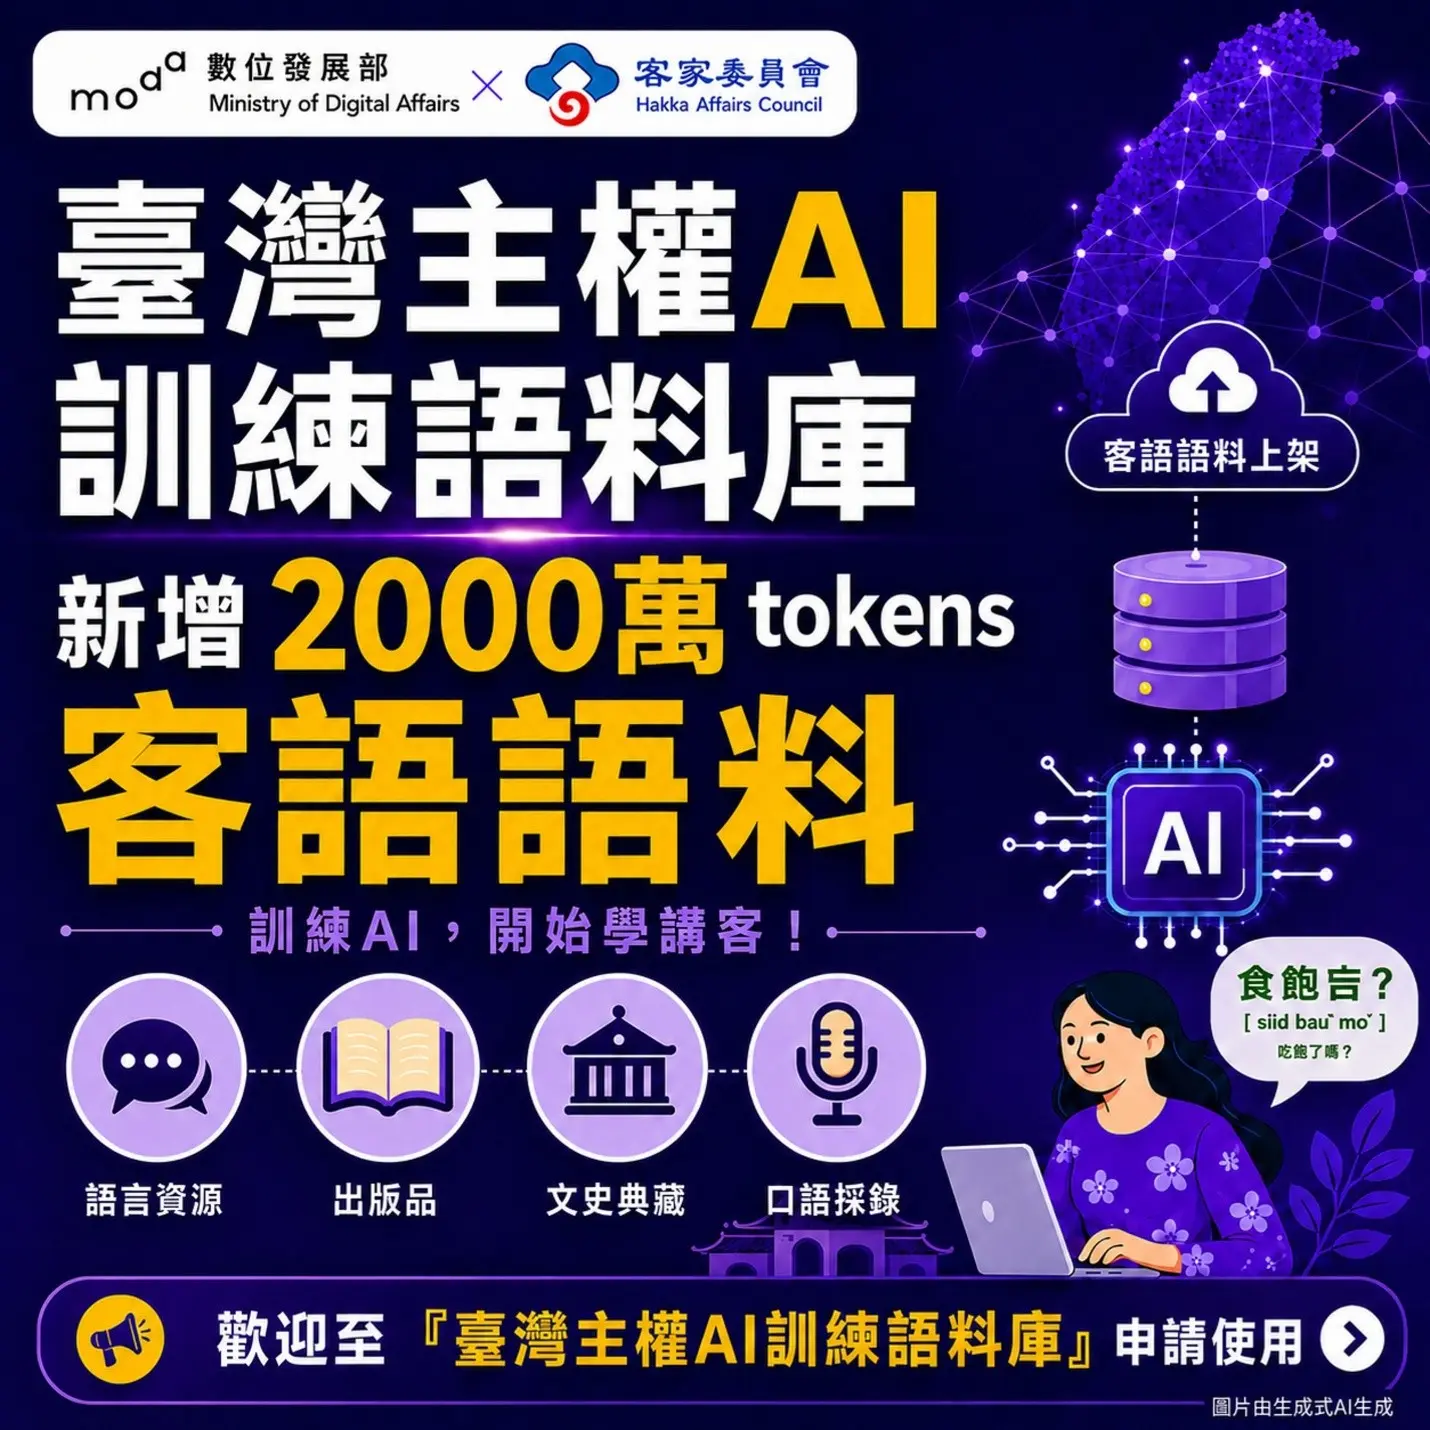
【要聞中心/綜合報導】客語作為我國國家語言之一,承載著深厚的歷史與文化底蘊。數位發展部與客家委員會合作推動「臺灣主權AI訓練語料庫」,正式上架客家語言資源、出版品、文史典藏及研究報告等多項珍貴內容,首度新增約2000萬詞元(tokens)的高品質訓練語料,為臺灣主權AI語料注入更豐富多元的文化及語言生命力。


報你知:Token(詞元)是什麼?
詞元(Token)是AI理解與處理人類語言的最小文字碎片。
當我們輸入一段話時,AI會將它切碎成一個個詞元,再轉換成電腦看得懂的數字來進行運算。
一個詞元不等於一個字,英文單字常被拆成數個字母組合,而一個繁體中文字也可能佔用一到兩個詞元。它就像是文字的積木,AI透過拼湊這些積木來組合出對話。
同時,詞元也是AI服務的計費標準與記憶限制,不論是輸入的指令還是AI的回覆,全都是以詞元總數來計算花費與容量。簡言之,詞元就是AI世界裡的文字貨幣與語意積木。
當我們輸入一段話時,AI會將它切碎成一個個詞元,再轉換成電腦看得懂的數字來進行運算。
一個詞元不等於一個字,英文單字常被拆成數個字母組合,而一個繁體中文字也可能佔用一到兩個詞元。它就像是文字的積木,AI透過拼湊這些積木來組合出對話。
同時,詞元也是AI服務的計費標準與記憶限制,不論是輸入的指令還是AI的回覆,全都是以詞元總數來計算花費與容量。簡言之,詞元就是AI世界裡的文字貨幣與語意積木。

數發部表示,本次客委會提供的語料內容極具指標性,主要涵蓋詩集創作、客家風情及客語教學圖書等政府出版品;客語能力認證各級詞彙教材與題庫、口語採錄文本、文化典藏,以及學術與政策研究資料,如客語復振、政策發展與文化治理等。
數發部表示,「臺灣主權AI訓練語料庫」自上線以來,已累積逾15億tokens語料量,將持續攜手政府機關釋出優質語料,同時深化公私協力,規劃推動民間語料徵集,逐步建構具臺灣主權代表性與專業知識的資料基石。
目前該批客語語料已正式上架,數發部歡迎AI模型開發團隊、學研機構及相關單位至「臺灣主權AI訓練語料庫」官網申請使用,共同驅動客語AI技術的蓬勃發展與多元應用落地,也歡迎各界將研究成果、應用案例及更多具臺灣特色的優質語料回饋至語料庫,讓更多創新想法持續發芽,共同壯大臺灣主權AI。